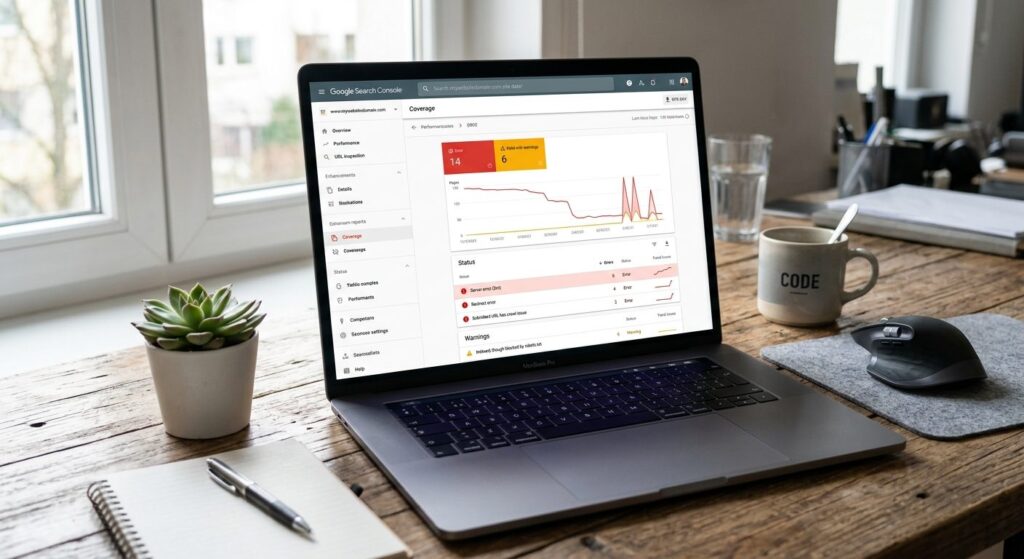
Skjulte SEO-fejl der koster dig organisk trafik er langt mere udbredte end de fleste webejere forestiller sig — og det farligste ved dem er netop, at de ikke råber op. Mens du tjekker dine titeltags og bygger backlinks, kan der ligge tekniske problemer dybt i din hjemmesides infrastruktur og stille og roligt æde din synlighed i Googles søgeresultater. Ingen advarsel. Ingen rød lampe. Bare en kurve der peger nedad.
- Broken internal links og duplicate content kan skade din ranking uden at udløse synlige fejl i browseren
- Crawl budget-problemer rammer primært større sider, men kan også ødelægge mellemstore webshops og informationssider
- Langsomme redirect-kæder sender negative signaler til Google og svækker PageRank-overførslen
- De fleste af disse fejl kan identificeres gratis med Screaming Frog, Google Search Console og PageSpeed Insights
Hvilke skjulte SEO-fejl saboterer din ranking mest
Når man taler om SEO-fejl, tænker de fleste på manglende metabeskrivelser, for korte tekster eller alt-tekster der er glemt. Det er klassiske fejl — men de er synlige. De fejl der virkelig koster dig organisk trafik på lang sigt, er dem du ikke ser, fordi de ikke manifesterer sig som fejlsider eller advarsler i dit CMS.
De mest skadelige skjulte SEO-fejl falder typisk i fire kategorier:
- Broken internal links uden 404-fejlsider — links der peger på sider med redirect-loops eller soft 404s
- Duplicate content i skjulte varianter — kanoniseringsproblemer der opstår via URL-parametre, session IDs eller HTTPS/HTTP-dubletter
- Crawl budget-spild — Googlebot bruger sine ressourcer på unødvendige eller uindexerbare URL’er
- Redirect-kæder og langsomme redirects — der forsinker crawling og svækker link equity
Fælles for dem alle er, at de kræver teknisk indsigt at opdage, og at skaden akkumulerer over tid. En enkelt broken internal link er harmløs. Hundrede er et problem. En enkelt redirect-kæde er ubetydelig. Femten er en ranking-dræber.
Vil du forstå, hvordan din URL-struktur og interne arkitektur påvirker disse problemer fra bunden, anbefaler vi at læse Sådan bruger nichestruktur og URL-arkitektur til at vinde organisk trafik — det giver det fundament, der gør resten af denne artikel mere meningsfuld.
Broken internal links uden 404-fejlsider
En klassisk 404-fejl er let at opdage: siden viser en fejlmeddelelse, Google Search Console flagrer den, og du ved, du skal rette den. Men hvad sker der, når et internt link ikke ender på en ægte 404, men i stedet på en side der teknisk eksisterer — bare ikke den rigtige?
Soft 404-sider og tomme kategorisider
En soft 404 er en side, der returnerer HTTP-statuskode 200 (OK) til Google, men reelt ikke indeholder relevant indhold. Det kan være tomme kategorisider i en WooCommerce-shop efter sæsonudsalg, søgeresultatsider uden resultater, eller sideinddelte arkivsider der er løbet tør for indhold.
Google opdager disse med tiden og begynder at devaluere dem — men i mellemtiden spiser de crawl budget og forvirrer Googlebots forståelse af din sitestruktur. Interne links der peger på soft 404s sender i praksis ingen rankingværdi videre.
Redirect-loops der begynder som interne links
En anden variant er interne links der peger på URL’er, som efterfølgende er omdirigeret — og omdirigeret igen. Du ender med kæder som:
/produkt-a/→ 301 til/shop/produkt-a/→ 301 til/shop/produkter/a/
Disse kæder er ikke brudne i traditionel forstand, men de svækker link equity for hver hop, og de gør det langsommere for Googlebot at crawle din side. Opdater dine interne links til altid at pege direkte på den endelige destination.
Sådan finder du dem
Brug Screaming Frog SEO Spider til at crawle dit site og filtrer på interne links med statuskoderne 3xx og soft 404s. Google Search Console viser også “Ikke fundet (404)” og “Omdirigeret” under Indeksering → Sider, men fanger ikke alle soft 404s.
Duplicate content som Google ikke kan se direkte
Duplicate content-problemer tænkes ofte som to sider med identisk tekst. Det er ét scenarie. Men de mest skadelige varianter opstår på teknisk niveau — og de er usynlige for det blotte øje.
URL-parametre der skaber tusindvis af varianter
Forestil dig en webshop med sorteringsmuligheder: /kategori/?sort=pris&farve=roed&side=2. Hver kombination genererer en unik URL med i princippet identisk eller næsten identisk indhold. Google ser disse som separate sider og skal bruge ressourcer på at afgøre, hvilken der er den “rigtige” — og i mange tilfælde kan det resultere i, at ingen af dem ranker særlig godt.
Løsningen er en kombination af:
- Canonical tags der peger alle parametervarianter mod den kanoniske URL
- URL Parameter-håndtering i Google Search Console (nu delvist erstattet af canonical-strategier)
- Robots.txt-regler der blokerer crawling af kombinationer, du aldrig vil indexere
HTTP vs. HTTPS og www vs. ikke-www
Et overraskende almindeligt problem er, at en hjemmeside reelt er tilgængelig på fire separate adresser:
http://eksempel.dkhttps://eksempel.dkhttp://www.eksempel.dkhttps://www.eksempel.dk
Hvis der ikke er konsistente 301-redirects til én kanonisk version, og canonical tags er sat korrekt, kan Google opfatte alle fire som selvstændige sider med duplikeret indhold. Tjek det med et simpelt browsertest og bekræft i Search Console, hvilken version der er registreret som primær.
Paginerede sider og printer-venlige versioner
Mange CMS-platforme genererer automatisk printer-venlige versioner af sider (/print/), mobilversioner (/m/) eller AMP-sider der ikke er korrekt kanoniseret. Disse fortæller Google, at der findes duplikeret indhold — og det forvirrer rankingprocessen.
Ifølge Googles officielle dokumentation om kanonisering er canonical tags den foretrukne metode til at håndtere disse situationer, men de skal bruges konsistent og korrekt — et forkert placeret canonical-tag kan aktivt skade rankingen for en side, der ellers ville have performet godt.
Crawl budget-problemer på større websteder
Crawl budget er et begreb, som mange SEO-specialister kender, men som sjældent forklares grundigt til webejere uden teknisk baggrund. Kort sagt: Googlebot har ikke ubegrænsede ressourcer til at crawle dit site. Der er en grænse for, hvor mange sider Google vil besøge inden for en given periode — og hvis dit site spilder den kapacitet på ubrugelige sider, bliver dine vigtigste sider crawlet sjældnere.
Hvornår er crawl budget et reelt problem?
For de fleste små blogs og virksomhedssider med under 500 sider er crawl budget sjældent et akut problem. Men det bliver hurtigt relevant hvis du:
- Driver en webshop med mange produktvarianter og filtermuligheder
- Har et indholdstungt site med tusindvis af artikler
- Bruger JavaScript-frameworks der genererer dynamiske URL’er
- Har mange wedsites fusioneret i ét domæne via redirects
Hvad æder dit crawl budget unødigt?
De primære syndere er:
- Facetterede navigationer i e-handel med eksponentielt mange URL-kombinationer
- Session IDs i URL’er — ældre platforme tilføjer stadig
?sessionid=xyz - Interne søgeresultatsider der indexeres og crawles, selvom de ikke bør det
- Uendelige kalenderarkiver i WordPress-blogs der genererer URLs for fremtidige måneder
- Duplikerede tags og kategorier med overlappende indhold
Optimer dit crawl budget
Start med at gennemgå din robots.txt-fil og bloker aktivt de URL-typer, du aldrig ønsker indexeret. Brug XML-sitemaps der kun indeholder de URL’er, du faktisk ønsker i Googles index — ikke automatisk genererede lister over alle tilgængelige sider. Overvåg Crawl Stats-rapporten i Google Search Console, der viser, hvad Googlebot reelt bruger sin tid på hos dig.
Dette hænger tæt sammen med din overordnede tekniske infrastruktur. Hvis dit site lider under crawl budget-problemer og du bruger WordPress, bør du også sikre, at din tekniske opsætning er stabil — herunder backups og serverkonfiguration. Læs mere i Derfor koster en dårlig WordPress-backup dig Google-placeringer.
Langsomme redirects der drainer din ranking
Redirects er nødvendige. Når du ændrer URL-struktur, fusionerer sider eller skifter domæne, er 301-redirects standardløsningen. Men de kommer med en pris — og jo flere led i kæden, jo højere er den pris.
Redirect-kæder og link equity-tab
Teknisk set overfører en korrekt implementeret 301-redirect næsten al link equity fra den gamle URL til den nye. Men “næsten” er nøgleordet. Med hver hop i en redirect-kæde mister du en lille mængde PageRank. Tre hop kan i praksis betyde, at en side, der skulle have arvet al linkværdi fra et gammelt URL, kun modtager 85-90 % af den.
Multiplér det med hundredvis af redirects på et ældre domæne, og du har et målbart ranking-tab.
Serverresponstid og redirect-latency
Udover link equity-tabet er der et hastighedsproblem. Hvert redirect kræver en ny HTTP-anmodning og et nyt serversvar. På en veloptimeret server tager det måske 50 millisekunder. På en overbelastet shared hosting kan det tage 300-500 ms per hop.
Google inkluderer sidens samlede indlæsningstid i sine rankingfaktorer, og Core Web Vitals måler specifikt Time to First Byte (TTFB) — som forringes direkte af redirect-latency.
Redirect-loops — den værste variant
En redirect-loop opstår, når Side A redirecter til Side B, der redirecter tilbage til Side A. Browsere opdager dette hurtigt og viser en fejlmeddelelse. Men Googlebot kan også støde ind i mere subtile loops der spænder over tre eller fire URL’er — og i de tilfælde holder Googlebot simpelthen op med at crawle de involverede sider.
Tjek dine redirects systematisk med Screaming Frog ved at aktivere “Follow redirects” og se efter kæder med mere end ét hop. Opdater alle interne links og eksterne links (hvor muligt) til at pege direkte på den endelige destination.
Hvordan du finder og fikser disse fejl selv
De gode nyheder er, at de fleste af disse skjulte SEO-fejl kan identificeres med gratis eller billige værktøjer — og at rettelserne, når de er identificeret, typisk ikke kræver en udvikler.
Trin 1: Screaming Frog SEO Spider
Screaming Frog er standarden for teknisk SEO-crawling. Den gratis version tillader crawling af op til 500 URL’er. Start med at crawle dit hele site og kig efter:
- Interne links med 3xx-statuskoder (redirect-kæder)
- Sider med duplicate page titles og duplicate H1’er
- Manglende eller duplikerede canonical tags
- Sider med meget lavt wordcount (potentielle soft 404s)
Trin 2: Google Search Console
Search Console er uundværlig fordi den viser, hvad Google faktisk ser på dit site — ikke hvad du tror den ser. Gennemgå:
- Dækningsrapport (Indeksering → Sider): Kig efter “Udelukket” og “Fejl”-kategorier
- Crawl Stats: Under Indstillinger → Crawl-statistikker — viser hvad Googlebot bruger sin tid på
- Core Web Vitals-rapporten: Identificerer sider med hastighedsproblemer
- Manuelle handlinger: Sjældne, men vigtige at tjekke
Trin 3: PageSpeed Insights og CrUX-data
Google PageSpeed Insights kombinerer laboratoriedata med reelle brugerdata fra Chrome User Experience Report. Det er det mest retvisende billede af, hvordan dine sider performer i praksis — og det er direkte koblet til dine Core Web Vitals-scores i Search Console.
Trin 4: Systematisk opfølgning
Teknisk SEO er ikke et engangsprojekt. Sæt en månedlig rutine op hvor du:
- Crawler dit site med Screaming Frog
- Gennemgår Search Console for nye fejl og fald i indexerede sider
- Tjekker Core Web Vitals for regressioner
- Validerer at nye sider har korrekte canonical tags og er inkluderet i sitemap
Hvis du bruger digitale formularer og dataintegration på dit site, kan du spare betydelig udviklingstid ved at automatisere tekniske processer — eksempelvis via Spar tid og fejl med CVR API i dine digitale formularer, der viser, hvordan automatisering reducerer menneskelige fejl og sikrer datakvalitet.
Ofte stillede spørgsmål
Kan skjulte SEO-fejl alene få en velfungerende side til at falde i ranking?
Ja — og det sker oftere end antaget. En akkumulation af tekniske fejl som crawl budget-spild, redirect-kæder og duplicate content kan over måneder erodere en sides autoritet i Googles øjne, selvom indholdet er af høj kvalitet og backlinkprofilen er sund. Teknisk SEO er fundamentet som alt andet hviler på. En stærk indholdsstrategi kompenserer ikke for et fundament med revner.
Hvor tit bør jeg crawle mit site for tekniske fejl?
For de fleste mellemstore sites anbefales en fuld teknisk crawl mindst én gang om måneden. Har du en aktiv webshop med hyppige produktopdateringer eller publicerer du indhold dagligt, bør du crawle mindst ugentligt. Google Search Console giver løbende notifikationer om kritiske fejl, men den erstatter ikke en systematisk gennemgang med Screaming Frog eller et lignende værktøj.
Er duplicate content altid en SEO-fejl, eller er der situationer hvor det er acceptabelt?
Duplicate content er ikke i sig selv en direkte straf fra Google, men det skaber forvirring om, hvilken version af en side der skal ranke — og Google vælger måske ikke den version du foretrækker. Brug canonical tags konsistent for at signalere den kanoniske URL. Lovpligtige tekster, vilkår og betingelser og lignende standardtekster der optræder på tværs af sites pådrager dig sjældent problemer, forudsat de ikke udgør kerneindholdet på nogen side.
Hvad er det hurtigste jeg kan gøre for at forbedre min tekniske SEO i dag?
Log ind i Google Search Console og gennemgå siden “Indeksering → Sider” for at se, hvilke sider Google ekskluderer og hvorfor. Dernæst: kør en gratis crawl med Screaming Frog og identificér redirect-kæder og broken links. Disse to trin tager under to timer og giver dig et klart billede af de mest presserende problemer, du kan begynde at rette med det samme — uden ekstern hjælp.